あなたの写真を喋らせるAI
写真を喋らせるAIは、一枚の写真を登場人物がセリフを話す短い動画に変えます。画像をアップロードし、台詞を書いて、Seedance が音声と口の動きを一度に生成します。実在する人物の肖像にも対応しています。
一枚の写真を入れて、話す動画が出る
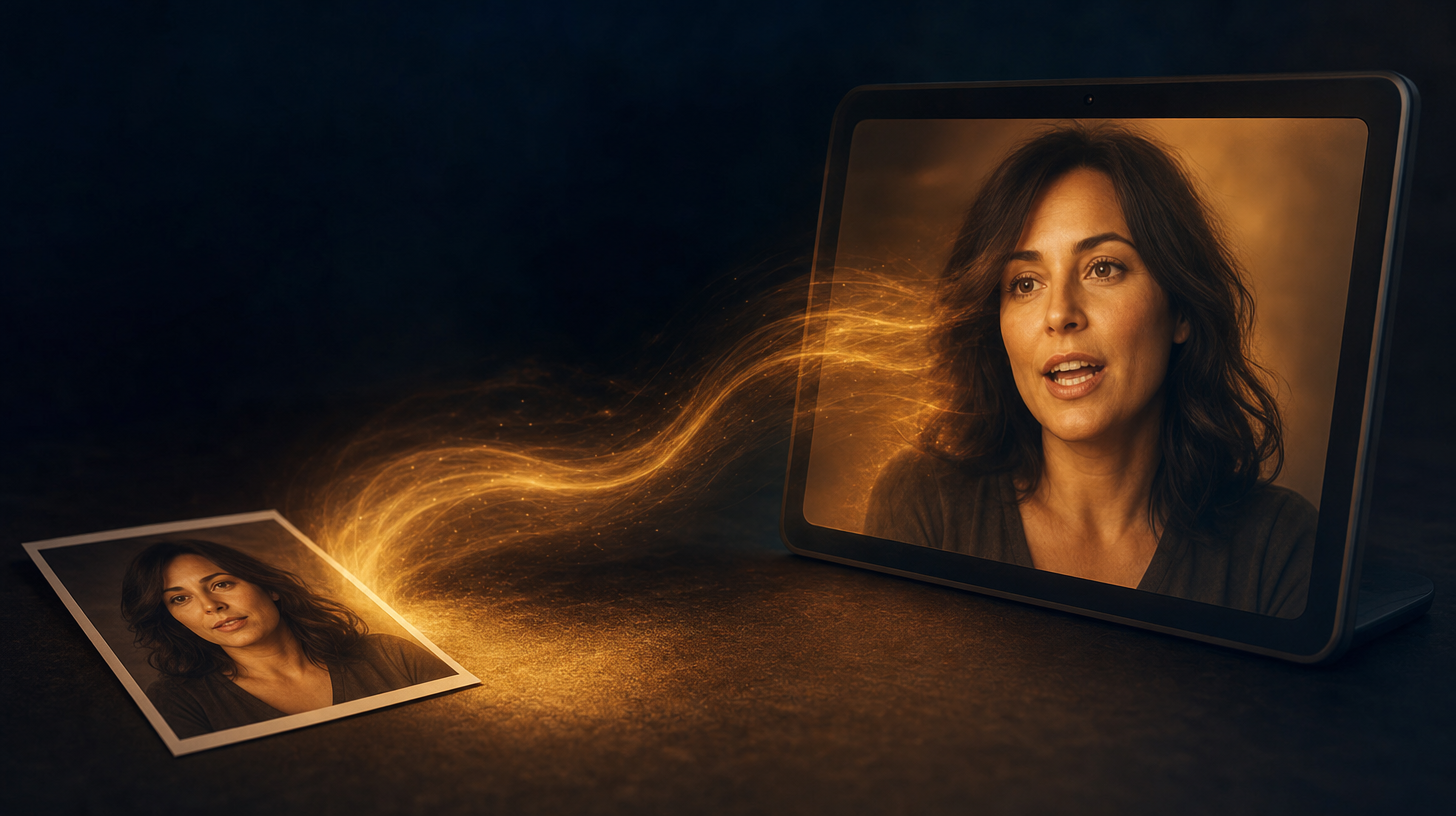
静止画をアップロードするだけで、写真を喋らせるAIが顔をアニメーション化して音声を追加します。平らな肖像画が話す動画に変わります。
写真を喋らせるAIにはビデオやリグは不要です。写真を追加して、台詞を入力して、生成するだけです。実在する人物の肖像に対応しており、その結果にはすでに音が付いています。
音声と口の動きが同時に生成される
写真を喋らせるAIでは、音声と口の動きが一度に生成されます。最初の結果は完成した映像音声ドラフトで、別のダビングツールは不要です。
セリフが含まれている場合、口の動きは写真を喋らせるAIの同じ結果の中で生成されます。すでに話している動画を確認して、ペース調整が必要なら入力文を修正します。
8言語以上で喋る
英語、日本語、韓国語、北京官話で台詞を書けば、写真を喋らせるAIが口の動きをその言語に合わせます。
同じ写真が今日は一つの言語で話し、明日は別の言語で話せます。入力文に言葉を設定すれば、写真を喋らせるAIが口を言葉に合わせて動かします。
セリフ、エフェクト、音楽が一度に作られる
Seedance ネイティブ音声は、音声、効果音、環境音、BGMを一度に生成します。写真を喋らせるAIから一度のレンダリングで、沈黙ではなく完成したサウンドトラックが得られます。
参照画像、動画、または音声クリップをオプションで追加して、スタイル、ペース、雰囲気をコントロールできます。これらの参照入力は写真を喋らせるAIでのムードをガイドし、あなたの画像と組み合わせます。
写真を喋らせるAIが静止画を話す動画に変える仕組み
写真を喋らせるAIは、被写体があなたのセリフを話す短い動画に写真を変えます。clipdance.ai では、一枚の画像をアップロードし、台詞を入力すれば、モデルが口の動きと合った合成音声を生成します。音声は録音ではなく、スクリプトから来ています。
一枚の写真をアップロード
単一の肖像画を用意します。写真を喋らせるAIが顔を読み込み、動きに備えます。実在する人物の肖像にも対応しています。
台詞を書く
入力文に正確なセリフを入力します。あなたが書いたものが全て、写真を喋らせるAIが動画で話すスクリプトになります。
音声が自動生成される
あなたが録音する必要はありません。写真を喋らせるAIがテキストから合成音声を作り、その後、口の動きを音声に合わせます。
口の動きがぴったり合う
音声と口の動きはこの写真を喋らせるAIで一緒に生成されます。唇が言葉と一緒に動き、動画がすでに喋った状態で到着します。
多言語対応の写真を喋らせるAI
英語、日本語、韓国語、北京官話など複数言語で書けます。写真を喋らせるAIは8言語以上に対応し、口を選択した言語に合わせます。
完成した音がミックスされる
各レンダリングは、話されたセリフと効果音、環境音、BGMを含むことができます。写真を喋らせるAIは完成した音の結果を提供します。
写真を喋らせるAIの仕組み
写真を喋らせるAIで、写真からセリフまで3ステップ
あなたの写真をアップロード
画像から動画へのツールを開き、一枚の画像を追加します。明るく、正面向きの肖像画は、写真を喋らせるAIに最も多くの情報を提供します。
彼らが何を言うかを書く
入力文に台詞を言葉通りに書いて、写真を喋らせるAIがスクリプトを持つようにしてから、「音声生成」をオンのままにします(デフォルト)。Seedance 2 の入力文チューニングガイドが、行を上手に作成するのに役立ちます。
生成して確認
生成ボタンを押します。写真を喋らせるAIからの最初の結果は、音を含む完全な動画です。すぐに話す動画を見て、その後、台詞を調整します。
写真を喋らせるAI よくある質問
今日から写真を喋らせるAIを始めよう
一枚の写真を用意し、セリフを書いて、写真を喋らせるAIに口の動きが合った話す動画に変えてもらいます。無料クレジットでサインアップ(カード不要)し、数分で最初の喋る写真を作成します。
あなたの写真を喋らせる